Qué es Jev: el modelo de IA que decide en milisegundos y no escribe
Escrito por Jon • 25 de septiembre de 2026
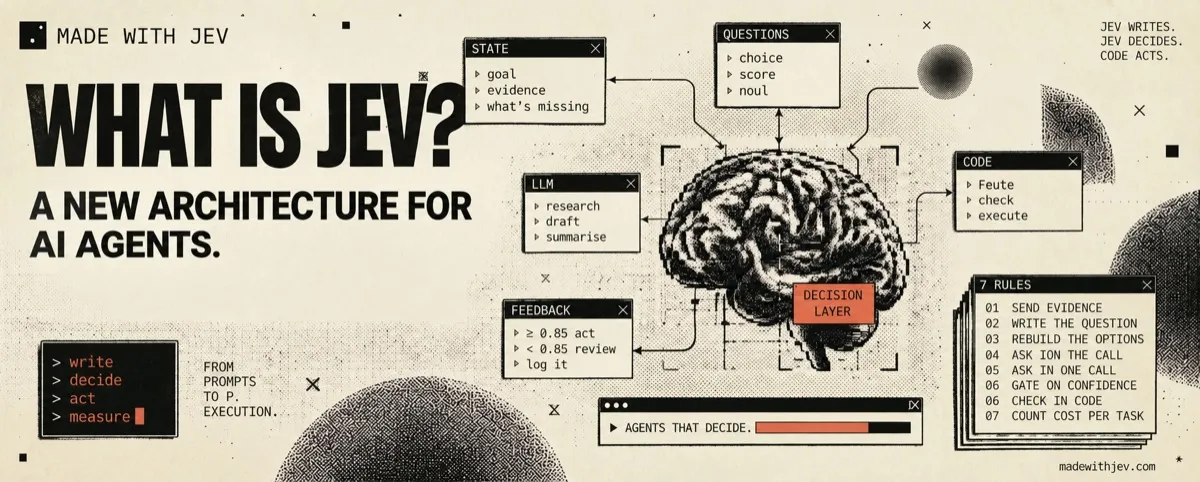
Jev no escribe. Decide.
Es el primer modelo System One de TypeSafe AI y salió el 15 de septiembre de 2026. Le pasás un texto —un correo, un ticket, una página— y te devuelve una decisión lista para usar en tu código, con la probabilidad de cada opción, en menos de medio segundo.
No es un chatbot. No redacta, no resume y no genera código. Y ese límite es justamente la característica.
Acá va qué es, cómo funciona por dentro, cuánto cuesta frente a un modelo grande y qué está construyendo la gente con él.
¿Qué es Jev en una frase?
Jev es un motor de decisiones semánticas: entra un estado sin estructura y salen respuestas con tipo y probabilidad.
TypeSafe AI lo describe como «una llamada de función con inteligencia de frontera: estado sin estructura dentro, decisiones tipadas con probabilidad fuera». La idea es simple: cuando tu código ya sabe cuáles son las respuestas posibles, pedirle a un modelo que escriba un párrafo es un desperdicio.
¿Por qué existe un modelo que no escribe?
Porque la mayoría del software no necesita otro chatbot. Necesita hacer miles de juicios pequeños que hoy resuelve mal o caro.
- ¿Este ticket es urgente?
- ¿Qué modelo debería atender esta petición?
- ¿Este comando es peligroso?
- ¿Este pasaje responde la pregunta del usuario?
Hoy cada uno de esos juicios va a un LLM: el modelo redacta una respuesta, tu código la parsea, la valida y reintenta cuando el formato sale mal. Para una decisión con cinco respuestas posibles, eso es lento y caro.
El nombre viene de «Pensar rápido, pensar despacio», de Daniel Kahneman: el Sistema 1 es el juicio rápido y automático. Y «Jev» viene de William Stanley Jevons, que en 1865 notó que usar el carbón de forma más eficiente aumentó la demanda, no la redujo. Abaratá una decisión y el software va a tomar muchísimas más.
¿Cómo funciona? Estado, preguntas y confianza
Una llamada a Jev tiene dos partes: el estado (el texto que se evalúa) y las preguntas que querés responder sobre ese estado.
Hay tres tipos de pregunta y se pueden mezclar en la misma llamada:
- Choice — elegir una opción de una lista que vos definís. Hasta 255 opciones. Devuelve la opción, la probabilidad de cada una y la confianza.
- Score — ubicar la entrada en una escala ordenada que vos definís (bajo, medio, alto).
- Noul — responder sí o no, devolviendo la probabilidad de que sea verdadero: un número entre 0 y 1.
Jev evalúa todas las preguntas en paralelo contra el mismo estado, así que sesenta preguntas cuestan casi lo mismo que una.
El detalle que más importa es la confianza. No es la probabilidad de la opción ganadora: es cuánto está seguro el modelo. En el ejemplo del quickstart oficial, un ticket se clasifica como facturación con 0,84 de probabilidad, pero técnico se lleva 0,159, así que la confianza cae a 0,596. La respuesta elegida es facturación. La confianza te dice si tu código debería actuar solo o escalar a una persona.
Las probabilidades dicen qué opción gana. La confianza dice si actuás. Ahí está el sistema entero.
Un matiz importante para no citar mal a TypeSafe: Jev no puede devolver una opción fuera del esquema que definiste. No inventa un campo ni rompe el JSON. Pero puede elegir con seguridad la opción válida equivocada. La frase segura es: Jev no puede romper el esquema, pero puede equivocarse.
¿Cuánto cuesta Jev y cuánto tarda?
La entrada cuesta 0,042 USD por millón de tokens y la salida es gratis. La latencia oficial está entre 70 y 500 milisegundos por respuesta.
En los evals de flujos de trabajo que publica TypeSafe, la media de cuatro flujos queda así:
| Modelo | Precisión | Coste por caso | Tiempo por caso |
|---|---|---|---|
| Jev | 67,8 % | 0,0004 USD | 0,4 s |
| Sonnet 5 | 67,8 % | 0,1174 USD | 78,1 s |
| Opus 5 | 73,1 % | 0,1761 USD | 37,8 s |
| Terra | 67,9 % | 0,0304 USD | 10,1 s |
| Haiku 4.5 | 53,6 % | 0,0195 USD | 12,5 s |
Misma precisión que Sonnet 5, unas 290 veces más barato y medio segundo en lugar de más de un minuto. Opus 5 sigue siendo el más preciso.
Dos matices antes de citar estos números: las etiquetas de referencia las ponen dos modelos grandes de razonamiento, no personas; y por tarea el resultado no es uniforme, la media esconde flujos donde Jev va mejor y flujos donde va peor.
En su portada, TypeSafe resume la ventaja en 193,6 veces más rápido y 444,6 veces más barato. Son sus propios evals y están en el extremo favorable del rango.
Límites actuales: modelo jev-1.13.0 (jev-latest apunta ahí), 250.000 tokens por segundo, 1.200 peticiones por minuto, 64k tokens por petición (32k para el estado más la pregunta más larga) y entrada solo de texto. Nada de imágenes, audio ni vídeo por ahora.
¿Qué está construyendo la gente con Jev?
En diez días, desde el lanzamiento hasta el 25 de septiembre, madewithjev.com —un directorio que reúne proyectos hechos con este modelo— lleva catalogados 730 proyectos de 668 autores distintos.
Cada ficha enlaza a la fuente original y muestra las cifras que publicó su autor: la latencia y el coste que midió, si los dio. Ningún número lo mide el directorio.
De esos 730, 331 publican alguna cifra y solo 55 publican un coste. Con esos datos, la mediana real de coste por decisión es 0,000068 USD: unas 14.700 decisiones por dólar. El proyecto más barato llega a 170.900 por dólar. La mediana de latencia son 300 milisegundos.
Algunos ejemplos que salen del catálogo:
- Doom. La demo de lanzamiento de TypeSafe: el estado del juego entra como texto y Jev devuelve la siguiente jugada diez veces por segundo, por unos 7 USD la hora.
- Detección de fraude en correos. 100 correos revisados en 1,42 segundos y los dudosos derivados a un modelo grande, por unos 0,07 USD el pipeline completo.
- 1.018 papers clasificados por tema por 0,08 USD, con una mediana de 256 milisegundos por paper.
- 724 anuncios de 37 marcas desglosados en unos 40 segundos por unos 0,09 USD.
El patrón se repite: nadie le pide a Jev que escriba. Le piden que decida. Lo que cambia no es que esas comprobaciones fueran imposibles, sino que ahora cuestan tan poco que vale la pena hacerlas en todas partes.
Si querés probarlo sin escribir código, el detector de slop con IA del mismo directorio está hecho con Jev.
¿Cuándo conviene usar Jev y cuándo no?
Elegilo cuando la misma decisión se repite miles de veces, las opciones posibles las sabés de antemano, la entrada es texto y vas a medir la confianza con tus propios datos antes de dejar que el código actúe solo.
No lo elijas cuando:
- Hay que escribir. Borradores, resúmenes y código siguen necesitando un modelo generativo.
- No sabés las opciones. Una Choice admite 255 como máximo. Si el espacio de respuestas no está cerrado, Jev no es la herramienta.
- La entrada no es texto. Acepta cadenas, objetos JSON y listas de textos. Nada de imagen, audio ni vídeo por ahora.
- La tarea pide aritmética o conteo exacto. Eso se queda en código.
⚠️ Regla práctica: si un
ifya resuelve el problema, dejá elif. Jev sirve para el juicio difuso que el código no puede calcular de forma fiable.
Preguntas frecuentes
¿Jev es gratis?
No. La entrada cuesta 0,042 USD por millón de tokens y la salida no se cobra. El acceso es en early access a través de la API de TypeSafe.
¿Jev reemplaza a ChatGPT o a Claude?
No. Un LLM escribe, resume, explica y usa herramientas. Jev solo decide. Se usan juntos: el LLM produce el plan o el texto, y Jev enruta, clasifica, verifica o pone el candado antes de una acción.
¿Jev alucina?
No puede devolver una respuesta fuera del esquema que definiste: nunca rompe el tipo. Sí puede elegir la opción válida equivocada. La seguridad de tipos no garantiza que el juicio sea correcto.
¿Necesito saber programar para usar Jev?
Para integrarlo en una app, sí: se llama desde código. Si no programás, lo más práctico es usar una herramienta ya hecha con Jev, como el detector de slop del directorio, o pedirle a quien te construye la app que integre una llamada.
¿En qué se diferencia de un clasificador clásico?
Un clasificador entrenado necesita datos etiquetados y una categoría por modelo. Jev recibe las opciones en la llamada, en texto, y devuelve probabilidad y confianza sin reentrenar.
¿Vale la pena mirarlo ahora?
Si en tu producto hay una decisión que se repite —clasificar, enrutar, verificar, moderar— y hoy la resuelve un LLM lento o una regla que se rompe con el primer caso raro, Jev es la primera opción pensada para ese hueco.
El mejor punto de partida es ver cómo otra gente resolvió el mismo problema con menos coste y menos espera: hay 730 ejemplos públicos, cada uno con su enlace y sus números.
Si querés entender cómo encaja una decisión como esta dentro de un sistema mayor, empezá por qué es un agente de IA, seguí por qué es el vibe coding y dejá a mano el glosario de términos de IA.
Para seguir explorando el mundo de la inteligencia artificial y sus avances, visitá queia.es.